AI마다 일을 나눠주기 시작했습니다
AI를 여러 개 쓰기 시작하면서 가장 먼저 바뀐 것은 모델을 고르는 기준이었습니다. 하나를 정해 모든 일을 맡기기보다, 일의 단계마다 잘 맞는 AI를 배치하는 쪽으로 바뀌었습니다.
AI를 여러 개 쓰기 시작하면서 가장 먼저 바뀐 것은 모델을 고르는 기준이었습니다. 하나를 정해 모든 일을 맡기기보다, 일의 단계마다 잘 맞는 AI를 배치하는 쪽으로 바뀌었습니다.
2025년 12월 5일 제가 아이타스에게 설명했던 방식은 이랬습니다.
| 작업 | 당시 주로 맡긴 AI |
|---|---|
| 기획의 틀과 이유 정리 | GPT |
| 기획을 개발문서로 옮기거나 검토 | Codex |
| 실제 개발 | Claude |
| 여러 자료를 묶어 정리 | NotebookLM |
이 표는 모델의 서열표가 아니었습니다. 같은 도구도 일이 달라지면 배치가 바뀌었습니다. Codex로 코딩하다가 Claude로 옮기기도 했고, Claude에 맡긴 분석이 맞지 않으면 다시 다른 도구를 찾았습니다. 중요한 것은 “어느 AI가 제일 좋은가”가 아니라 “지금 이 단계에서 어떤 일을 넘길 것인가”였습니다.
당시의 기본 흐름을 단순하게 적으면 다음과 같습니다.
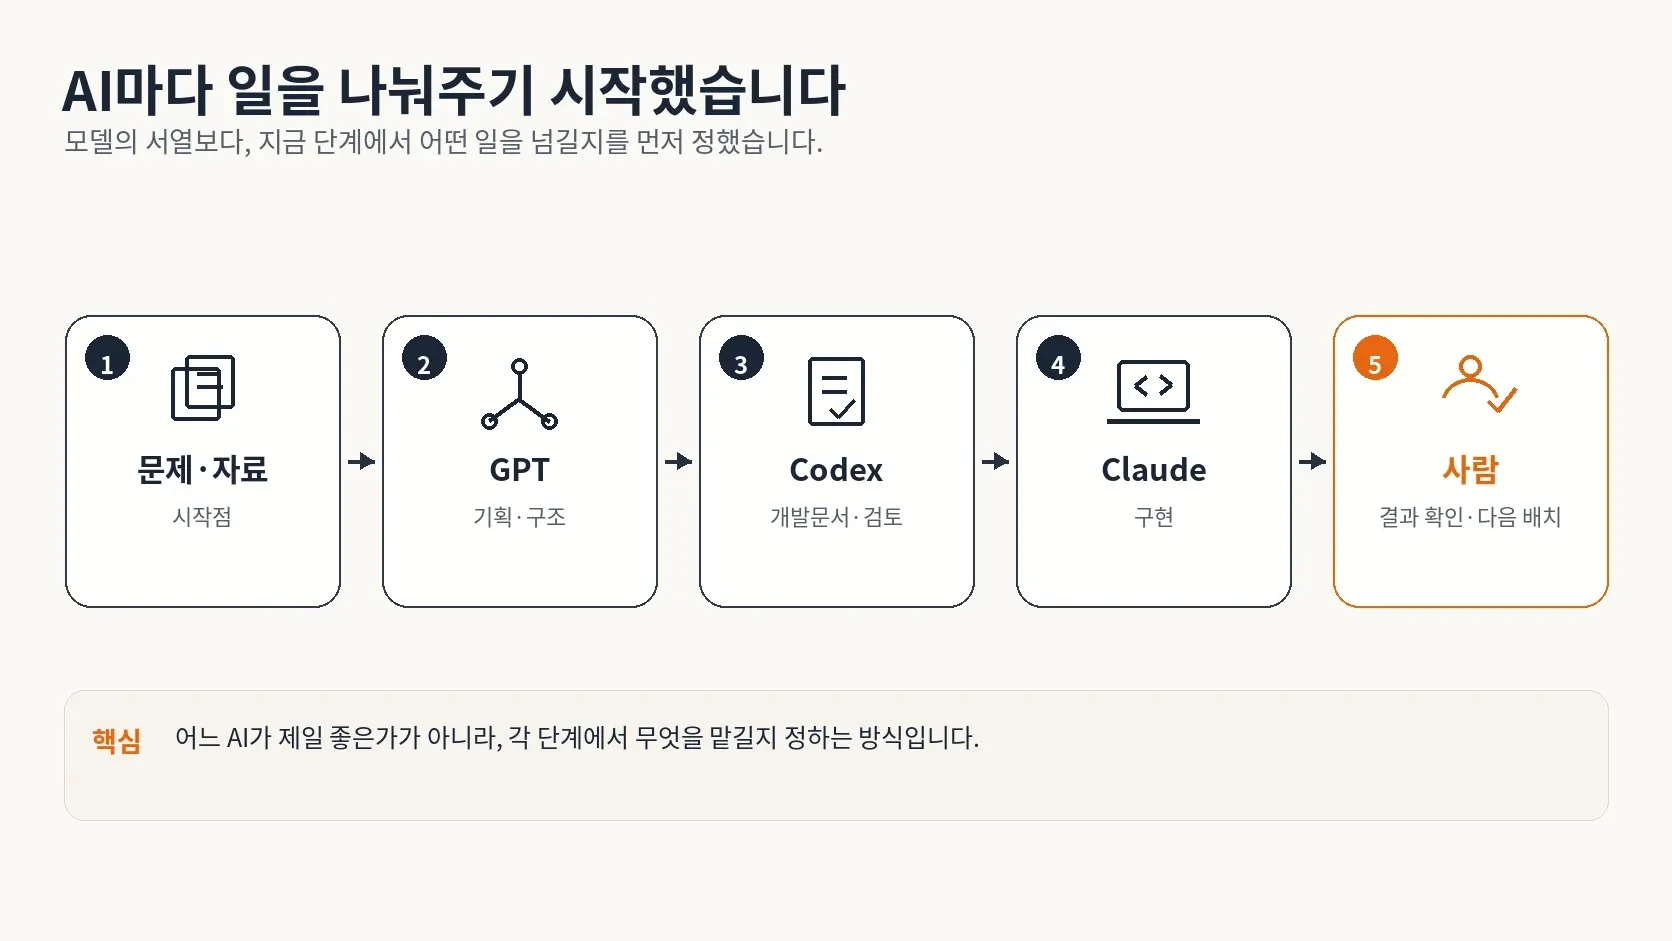
여기에서 사람의 역할은 사라지지 않았습니다. 어떤 결과를 다음 단계로 넘길지, 내용이 확정됐는지, 다시 검토해야 하는지를 제가 판단했습니다. 모델을 여러 개 쓴다고 해서 그 사이의 맥락까지 자동으로 이어지는 것은 아니었기 때문입니다.
실제로 이 방식의 첫 병목은 인수인계였습니다. 한 AI가 만든 결과를 다른 AI에게 넘길 때마다 배경을 다시 설명해야 했습니다. 어느 내용이 확정됐고 무엇이 아직 검토 중인지도 사람이 정리해야 했습니다. 역할은 나눴지만, 작업 상태를 공유하는 구조는 아직 없었습니다.
이 경험 뒤에 남은 원칙은 모델 이름보다 역할을 먼저 정하는 것입니다.
- 이번 단계의 목적은 무엇인가.
- 다음 작업자가 받아야 할 결과는 무엇인가.
- 어디까지 AI가 만들고, 어디에서 사람이 확인할 것인가.
이 세 가지가 정해지면 모델을 바꾸더라도 작업 흐름은 유지할 수 있습니다. 반대로 모델 이름만 정하고 인수인계를 설계하지 않으면, 여러 AI를 사용해도 사람이 계속 복사하고 설명하는 중계자가 됩니다.
그래서 다음 문제는 자연스럽게 “AI를 어떻게 나눠 쓸까”에서 “나눠 놓은 AI들이 어떻게 일을 이어받게 할까”로 넘어갔습니다.